
På denne siden
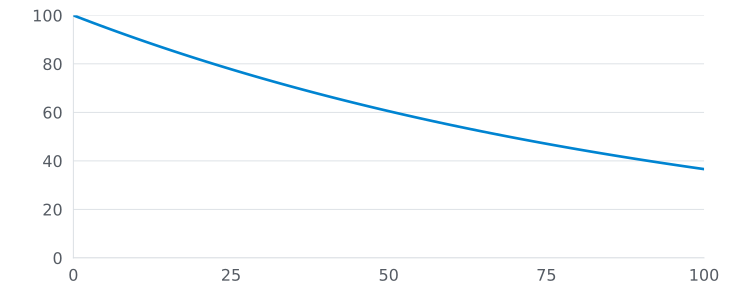
Se for deg en nettleseroppgave med hundre steg. Anta at hvert steg lykkes i 99 % av tilfellene, uavhengig av de andre. Sannsynligheten for at alle steg lykkes, er 0.99^100, eller rundt 36,6 %.
Nittini prosent høres utmerket ut. Trettiseks prosent gjør ikke det.
Kildens diskusjon av nettleseroppgaver som transaksjoner bruker regnestykket til å vise et avgrenset poeng: Kunden får verdi når oppgaven er ferdig, mens kostnader og feilrisiko samler seg ved hvert steg. Dette er matematikk under en antakelse, ikke en publisert suksessrate for en nettleseragent eller en Tajo-synkronisering. Virkelige feil kan være avhengige av hverandre. Én utløpt pålogging kan ødelegge flere senere handlinger samtidig.
Det nyttige spørsmålet er derfor ikke «Hvor presist var modellens siste klikk?» Det er «Oppstod tilstanden brukeren ba om?»
Det er hele transaksjonen som teller
Se for deg en agent som åpner en forsikringsportal, finner et dokument, laster det ned og kontrollerer at det tilhører riktig konto. Den kan navigere riktig gjennom 99 skjermbilder og likevel laste ned feil fil på skjermbilde 100. En logg full av vellykkede klikk retter ikke resultatet.
Det samme skillet gjelder en integrasjon. En agent kan finne et API, foreslå en feltmapping og lagre et utkast. Ingen av handlingene betyr at en kontakt i målsystemet nå har riktig samtykkestatus. Arbeidet er først ferdig når den godkjente operasjonen er kjørt og den relevante sluttilstanden kontrollert.
Dette er forskjellen mellom aktivitet og fullføring. Aktivitet er lett å telle. Fullføring må defineres.
For en nedlastet fil kan definisjonen være en fil der kontonummeret samsvarer med forespørselen. For en kontaktsynkronisering kan det være en post i målsystemet med riktig identifikator, riktige felt og riktig status for tillatelse til å sende meldinger. Kontrollen må undersøke det brukeren faktisk brydde seg om. Et grønt svar fra det forrige kallet viser at et kall returnerte. Det viser ikke nødvendigvis at målsystemet ble endret slik det skulle.
Tajos guide til å koble sammen bedriftsverktøy begynner med arbeidsflyten og fasiten for hvert dataobjekt. Disse valgene gir den siste kontrollen mening. Hvis to systemer begge hevder å eie et felt, kan selv en perfekt utført oppdatering gi feil tilstand på lengre sikt.
Prisen for enda en beslutning
Med den samme hypotetiske antakelsen om 99 % gir ti uavhengige beslutninger rundt 90,4 % sjanse for at hele kjeden lykkes. Femti gir rundt 60,5 %. Hundre gir rundt 36,6 %.
Sannsynlighet for at hele kjeden lykkes (%)
Antall uavhengige steg
- Antatt 99 % suksess per steg
Se de beregnede verdiene
| Steg | Suksess for hele kjeden (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
Kurven faller bratt fordi multiplikasjon ikke tar hensyn til et godt gjennomsnitt. Hver ekstra beslutning må fortjene plassen sin.
Det betyr ikke at alle API-kall skal samles i én enorm operasjon. Noen kall følger faste regler: hent en side med en kjent markør, sammenlign en identifikator, eller skriv et felt etter en godkjent mapping. En modell trenger ikke ta disse beslutningene på nytt for hver post. Andre kall innebærer reell tvil: et nytt felt hos en leverandør, en endret feilmelding eller en forespørsel der ansvaret er uklart. Da kan vurdering være nødvendig.
Det praktiske skillet er å bruke vurdering til å lage eller rette en regel, og så la vanlig kode anvende den stabile regelen. Reverse ETL er et nyttig eksempel på gjentatt dataflytting: Det er datapipelinen, ikke en samtale, som bør utføre hver rutineoperasjon på en rad. En agent kan fortsatt hjelpe med å avgjøre hva pipelinen skal gjøre.
Dette er en grense, ikke et slagord. Hvis en leverandør endrer betydningen av et felt, kan en fast regel gjenta feil handling helt perfekt. Systemet må kunne oppdage at antakelsene er endret og sende saken tilbake til gjennomgang.
Hvorfor ett stort verktøy ikke er svaret
En rimelig innvending er: «Hvis lange kjeder feiler, legg hele oppgaven bak ett verktøykall.» Det hjelper når verktøyet utfører en tydelig definert transaksjon med et resultat som kan kontrolleres. Det feiler når verktøyet bare skjuler en lang, usikker prosess.
Anta at syncCustomer() returnerer success: true etter å ha sendt en oppdatering. Hvis målsystemet behandler oppdateringer senere, kan kallet ennå ikke bevise kontaktens endelige tilstand. Verktøyet reduserte antall synlige steg. Det reduserte ikke usikkerheten.
Et bedre grensesnitt viser tilstandene som betyr noe: mottatt, anvendt, kontrollert eller feilet. Ordene må svare til faktisk dokumentasjon. En mottatt oppdatering kan være nok for en forhåndsvisning med små konsekvenser. En endring i en kampanjemålgruppe eller et samtykke bør kontrolleres i målsystemet før noen kaller jobben ferdig.
I denne foreslåtte Tajo-visningen er en godtatt forespørsel og en utført oppdatering noe annet enn en verifisert tilstand i målsystemet. Den siste kontrollen venter. Dermed har neste handling et formål: å undersøke hva målsystemet lagret. Å telle enda et vellykket verktøykall ville la det opprinnelige spørsmålet stå ubesvart.
En fullført skriving trenger fortsatt bevis
Ble kundesynkroniseringen fullført?
Skriving utført. Verifisering venter.
Tilstanden i målsystemet er ikke kontrollert ennå.
Synkroniseringsaktivitet
- Forespørsel godtatt
- Oppdatering utført
- Målkontroll venter
Eksempelkjøring · 14:32 UTC
Det vi vet
- Leverandørens svar
- Godtatt
- Skriveresultat
- Utført
- Tilbakelesing fra målsystemet
- Venter
Et vellykket kall beviser ikke sluttilstanden.
Foreslått utforming inspirert av Tajos aktivitetslogg. Illustrasjonen legger til en verifiseringstilstand; den hevder ikke at tilbakelesing fra målsystemet allerede er implementert.
Det endrer også hva du bør måle. Registrer antall forsøk hvis det forklarer kostnadene. Registrer feil underveis hvis de peker mot et ødelagt steg. Men vurder arbeidsflyten etter kontrollerte, fullførte transaksjoner, med kontrollmetoden skrevet ved siden av tallet. Et team som rapporterer at «99 % av kallene lyktes», har ikke svart på om kundene fikk jobben gjort.
Forklaringen av MCP-servere viser hvordan verktøy lar en assistent kalle et annet system. Tilgang til verktøyet er bare begynnelsen. Avtalen handler om tilstanden som blir stående igjen.
Hundre gode klikk kan fortsatt ende uten et resultat. Tell resultatet.
Ofte Stilte Spørsmål
Hvorfor feiler en lang arbeidsflyt når hvert steg vanligvis er riktig?
Hvis hvert steg lykkes uavhengig med sannsynlighet p, lykkes hele kjeden med n steg med sannsynlighet p opphøyd i n. Med antatt 99 % per steg lykkes hundre steg samlet i rundt 36,6 % av tilfellene. Virkelige feil kan henge sammen, så regnestykket er et eksempel, ikke en målt suksessrate for agenter.
Garanterer færre verktøykall bedre pålitelighet?
Nei. Færre kall hjelper bare hvis den samlede operasjonen fortsatt viser riktige kontroller og punkter der feil kan rettes. Ett ugjennomsiktig kall kan skjule en mislykket skriving like lett som en lang kjede kan miste tråden.
Hva bør et team måle for en agentbasert arbeidsflyt?
Mål om brukerens transaksjon er fullført og kontrollert, ikke bare om modellkallene lyktes. Definer filen eller tilstanden i målsystemet som beviser at jobben er gjort, og registrer hvor ofte den finnes etter hele arbeidsflyten.