
Op deze pagina
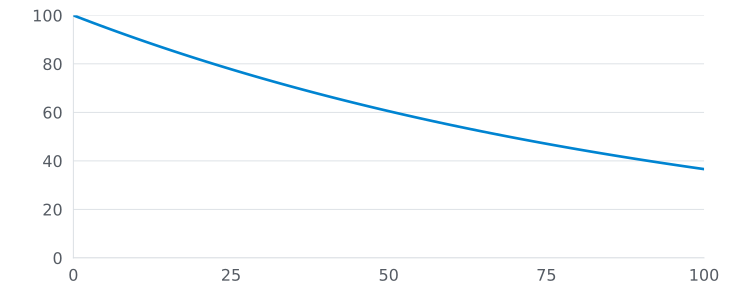
Neem een illustratieve browsertaak met honderd stappen. Stel dat elke stap in 99% van de gevallen slaagt, onafhankelijk van de andere. De kans dat alle stappen goed gaan is 0.99^100, ongeveer 36,6%.
Negenennegentig procent klinkt uitstekend. Zesendertig procent niet.
De brondiscussie over transacties in browserworkflows gebruikt deze berekening voor één beperkt punt: de klant krijgt waarde als de taak af is, terwijl kosten en risico bij elke stap oplopen. Het is rekenen met een aanname, geen gepubliceerd succespercentage voor een browseragent of Tajo-synchronisatie. Echte fouten kunnen samenhangen. Eén verlopen login kan meerdere latere handelingen tegelijk breken.
De bruikbare vraag is daarom niet: “Hoe goed was de laatste klik van het model?” Het is: “Is de gevraagde toestand van de gebruiker ontstaan?”
De transactie is de eenheid die telt
Stel je een agent voor die een verzekeringsportaal opent, een document zoekt, het downloadt en bevestigt dat het bij het juiste account hoort. Hij kan 99 schermen goed doorlopen en toch op scherm 100 het verkeerde bestand ophalen. Een log vol geslaagde klikken herstelt het resultaat niet.
Hetzelfde geldt voor een integratie. Een agent kan een API vinden, een veldtoewijzing voorstellen en een concept bewaren. Geen van die stappen betekent dat een contact in het doelsysteem nu de bedoelde toestemmingsstatus heeft. Het werk is pas klaar als de goedgekeurde handeling is uitgevoerd en de relevante eindvoorwaarde is gecontroleerd.
Dit is het verschil tussen activiteit en voltooiing. Activiteit is makkelijk te tellen. Voltooiing vraagt om een definitie.
Voor een download kan dat een bestand zijn waarvan het accountnummer bij het verzoek past. Voor contactsynchronisatie kan het een record zijn met de juiste identificatie, velden en toegestane status voor berichten. De controle moet het ding onderzoeken waar de gebruiker om gaf. Een groen antwoord op de vorige aanroep bewijst dat die aanroep antwoord gaf. Het bewijst misschien niet dat het doelsysteem is veranderd zoals bedoeld.
Tajo’s gids voor het verbinden van bedrijfshulpmiddelen begint bij de workflow en de gezaghebbende bron voor elk gegevensobject. Die keuzes bepalen wat de eindcontrole betekent. Als twee systemen allebei gezag over een veld opeisen, kan zelfs een perfect uitgevoerde schrijfactie op lange termijn de verkeerde toestand geven.
De prijs van nog een besluit
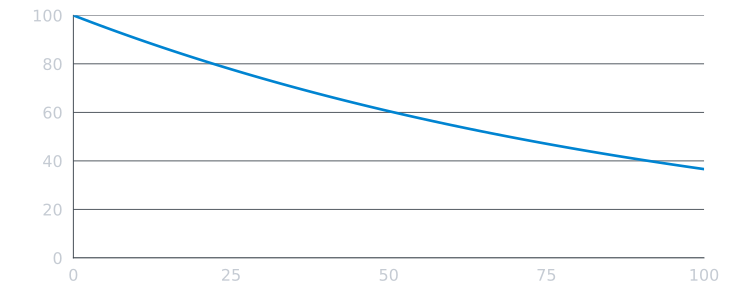
Onder dezelfde hypothetische aanname van 99% geven tien onafhankelijke besluiten ongeveer 90,4% kans op succes voor de hele keten. Vijftig geven ongeveer 60,5%. Honderd geven ongeveer 36,6%.
Kans op succes voor de hele keten (%)
Aantal onafhankelijke stappen
- Aangenomen 99% kans op succes per stap
Lees de berekende waarden
| Stappen | Succes voor de hele keten (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
De curve daalt snel omdat vermenigvuldiging geen rekening houdt met een goed gemiddelde. Elke extra beslissing moet haar plek verdienen.
Dat betekent niet dat je elke API-aanroep tot één reuzenhandeling moet samenvoegen. Sommige aanroepen zijn deterministisch: een pagina ophalen met een bekende cursor, een identificatie vergelijken of een veld schrijven volgens een goedgekeurde toewijzing. Een model hoeft daar niet voor elk record opnieuw over te beslissen. Andere aanroepen bevatten echte dubbelzinnigheid: een nieuw veld van een aanbieder, een veranderd foutbericht of een verzoek waarvan de eigenaar onduidelijk is. Daar kan beoordeling nodig zijn.
De praktische verdeling is: laat beoordeling een regel ontwerpen of herstellen en laat gewone code die stabiele regel toepassen. Reverse ETL is een voorbeeld van herhaalde gegevensverplaatsing: de pijplijn, niet een gesprek, hoort de routinehandeling voor elke rij uit te voeren. Een agent kan wel helpen bepalen wat de pijplijn moet doen.
Dit is een grens, geen leus. Verandert een aanbieder de betekenis van een veld, dan kan een deterministische regel de verkeerde handeling perfect herhalen. Het systeem moet merken dat zijn aannames veranderden en het geval opnieuw laten beoordelen.
Waarom één grote tool niet het antwoord is
Een redelijk bezwaar luidt: “Als lange ketens falen, stop de hele taak dan achter één toolaanroep.” Dat helpt als die tool een goed gedefinieerde transactie met controleerbaar resultaat is. Het faalt als de tool alleen een lang onzeker proces verstopt.
Stel dat syncCustomer() na het versturen van een update success: true teruggeeft. Verwerkt het doelsysteem updates later, dan kan de aanroep de definitieve contactstatus nog niet bewijzen. De tool verminderde de zichtbare stappen. De onzekerheid bleef.
Een betere interface toont de relevante toestand: geaccepteerd, toegepast, gecontroleerd of mislukt. Die woorden moeten bij bewijs horen. Een geaccepteerde schrijfactie kan genoeg zijn voor een voorbeeld met beperkte gevolgen. Een campagnedoelgroep of wijziging van toestemming verdient een controle in het doelsysteem voordat iemand het werk af noemt.
In deze voorgestelde Tajo-weergave zijn een geaccepteerd verzoek en een toegepaste update iets anders dan een gecontroleerde status in het doelsysteem. De laatste controle staat nog open. Daardoor krijgt de volgende stap een doel: nagaan wat het doelsysteem heeft opgeslagen. Nog een geslaagde toolaanroep tellen laat de oorspronkelijke vraag onbeantwoord.
Een voltooide schrijfactie vraagt nog bewijs
Is de klantsynchronisatie klaar?
Schrijfactie toegepast. Controle in afwachting.
De status in het doelsysteem is nog niet gecontroleerd.
Synchronisatieactiviteit
- Verzoek geaccepteerd
- Update toegepast
- Controle van doelsysteem in afwachting
Voorbeeldrun · 14:32 UTC
Wat we weten
- Antwoord van aanbieder
- Geaccepteerd
- Resultaat van schrijfactie
- Toegepast
- Teruglezen uit doelsysteem
- In afwachting
Een geslaagde aanroep bewijst de eindstatus niet.
Voorgestelde opzet op basis van Tajo's activiteitenoverzicht. De illustratie voegt een controlestatus toe; teruglezen uit het doelsysteem is hiermee geen bestaande functie.
Dat verandert ook wat je meet. Leg pogingen vast als dat helpt bij kostendiagnose. Registreer tussenfouten als ze een kapotte stap aanwijzen. Maar beoordeel de workflow op gecontroleerde afgeronde transacties, met de verificatiemethode naast het getal. Een team dat meldt “99% van de aanroepen slaagde” heeft nog niet verteld of klanten hun werk gedaan kregen.
De uitleg over MCP-servers laat zien hoe hulpmiddelen een assistent een ander systeem laten aanroepen. Toegang tot een tool is slechts het begin. Het contract is de toestand die achterblijft.
Honderd goede klikken kunnen niets opleveren. Tel het resultaat.
Veelgestelde vragen
Waarom faalt een lange workflow als de stappen meestal kloppen?
Als elke stap onafhankelijk slaagt met kans p, dan slaagt een keten van n stappen met kans p tot de macht n. Bij de aanname van 99% per stap haalt een keten van honderd stappen ongeveer 36,6%. Echte fouten kunnen samenhangen; dit is geen gemeten agentscore.
Garanderen minder aanroepen van hulpmiddelen betrouwbaarheid?
Nee. Minder aanroepen helpen alleen als de samengevoegde handeling de juiste controles en herstelpunten zichtbaar laat. Eén ondoorzichtige aanroep kan een mislukte schrijfactie even goed verbergen.
Wat moet een team meten bij een agentworkflow?
Meet of de transactie van de gebruiker aantoonbaar is afgerond, niet alleen of modelaanroepen slaagden. Definieer het resultaat of de doelsysteemtoestand die voltooiing bewijst en tel hoe vaak die na de hele workflow verschijnt.