
På denne side
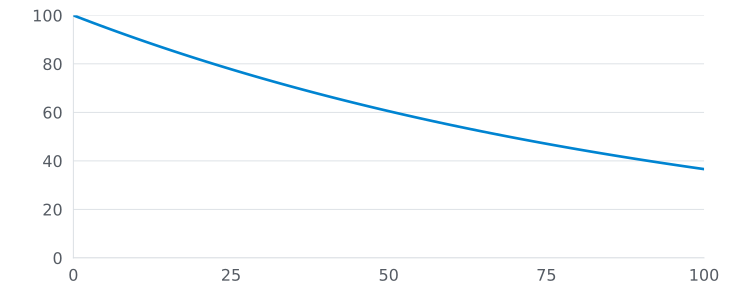
Forestil dig en browseropgave med hundrede trin. Antag, at hvert trin lykkes i 99 % af tilfældene, uafhængigt af de andre. Sandsynligheden for, at alle trin lykkes, er 0.99^100, altså cirka 36,6 %.
Nioghalvfems procent lyder fremragende. Seksogtredive procent gør ikke.
Kildens samtale om samlede browseropgaver bruger beregningen til at vise én ting: Kunden får værdi, når opgaven er færdig, mens omkostninger og risiko for fejl vokser ved hvert trin. Det er matematik under en antagelse, ikke en offentliggjort succesrate for en browseragent eller en synkronisering med Tajo. Virkelige fejl kan afhænge af hinanden. Ét udløbet login kan ødelægge flere senere handlinger på én gang.
Det nyttige spørgsmål er derfor ikke »Hvor præcist var modellens seneste klik?« Det er »Opstod den tilstand, brugeren bad om?«
Det er den samlede opgave, der tæller
Forestil dig en agent, der åbner en forsikringsportal, finder et dokument, henter det og kontrollerer, at det tilhører den rigtige konto. Den kan navigere korrekt gennem 99 skærmbilleder og stadig hente den forkerte fil på skærmbillede 100. En log fuld af vellykkede klik retter ikke resultatet.
Den samme forskel gælder en integration. En agent kan finde et API, foreslå en feltmapping og gemme et udkast. Ingen af de handlinger betyder, at en kontakt i målsystemet nu har den tilsigtede samtykkestatus. Arbejdet er først færdigt, når den godkendte handling er udført, og den relevante slutbetingelse er kontrolleret.
Det er forskellen på aktivitet og afslutning. Aktivitet er let at tælle. Afslutning kræver en definition.
Ved en filhentning kan definitionen være en fil, hvis kontonummer svarer til forespørgslen. Ved kontaktsynkronisering kan det være en post i målsystemet med korrekt id, korrekte felter og tilladt kommunikationsstatus. Kontrollen skal undersøge det, brugeren interesserede sig for. Et grønt svar fra det foregående kald viser, at et kald returnerede. Det viser ikke nødvendigvis, at målsystemet blev ændret som ønsket.
Tajos guide til at forbinde virksomhedsværktøjer begynder med arbejdsgangen og den autoritative kilde for hvert dataobjekt. De valg giver den sidste kontrol mening. Hvis to systemer begge bestemmer over samme felt, kan selv en perfekt udført opdatering give den forkerte tilstand på længere sigt.
Prisen for endnu en beslutning
Med samme hypotetiske antagelse om 99 % giver ti uafhængige beslutninger cirka 90,4 % succes for hele kæden. Halvtreds giver cirka 60,5 %. Hundrede giver cirka 36,6 %.
Sandsynlighed for succes i hele kæden (%)
Antal uafhængige trin
- Antaget 99 % succes pr. trin
Se de beregnede værdier
| Trin | Succes for hele kæden (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
Kurven er stejl, fordi multiplikation ikke tager hensyn til et godt gennemsnit. Hver ekstra beslutning skal gøre sig fortjent til sin plads.
Det betyder ikke, at alle API-kald skal samles i én enorm handling. Nogle kald følger faste regler: hent en side med en kendt cursor, sammenlign et id, eller opdater et felt efter en godkendt mapping. En model behøver ikke at træffe de beslutninger igen for hver post. Andre kald rummer reel tvivl: et nyt felt hos en leverandør, en ændret fejlmeddelelse eller en forespørgsel uden en klar ansvarlig. De kan kræve en vurdering.
Den praktiske opdeling er at bruge vurdering til at udforme eller rette en regel og derefter lade almindelig kode anvende den stabile regel. Reverse ETL er et nyttigt eksempel på gentagen flytning af data: Det er datapipelinen, ikke en samtale, der bør udføre hver rutinehandling på en række. En agent kan stadig hjælpe med at beslutte, hvad pipelinen skal gøre.
Det er en grænse, ikke et slogan. Hvis en leverandør ændrer et felts betydning, kan en fast regel gentage den forkerte handling perfekt. Systemet skal kunne opdage, at dets antagelser har ændret sig, og sende sagen tilbage til gennemgang.
Hvorfor ét stort værktøj ikke er svaret
En rimelig indvending er: »Hvis lange kæder fejler, så læg hele opgaven bag ét værktøjskald.« Det hjælper, når værktøjet udfører en klart defineret opgave med et kontrollerbart resultat. Det fejler, når værktøjet blot skjuler et langt, usikkert forløb.
Antag, at syncCustomer() returnerer success: true, efter at det har sendt en opdatering. Hvis målsystemet behandler opdateringer senere, kan kaldet endnu ikke bevise kontaktens endelige tilstand. Værktøjet har reduceret antallet af synlige trin. Det har ikke reduceret usikkerheden.
En bedre grænseflade viser de tilstande, der betyder noget: accepteret, anvendt, kontrolleret eller fejlet. Ordene skal svare til dokumentation. En accepteret opdatering kan være nok til en forhåndsvisning med små konsekvenser. En ændring af en kampagnes målgruppe eller samtykke fortjener en kontrol i målsystemet, før nogen kalder den færdig.
I denne foreslåede Tajo-visning er en accepteret anmodning og en anvendt opdatering ikke det samme som en verificeret destinationstilstand. Den sidste kontrol afventer stadig. Derfor har næste handling et formål: at undersøge, hvad destinationen gemte. At tælle endnu et vellykket værktøjskald ville lade det oprindelige spørgsmål stå åbent.
En afsluttet skrivning kræver stadig bevis
Blev kundesynkroniseringen færdig?
Skrivning anvendt. Verifikation afventer.
Destinationens tilstand er endnu ikke kontrolleret.
Synkroniseringsaktivitet
- Anmodning accepteret
- Opdatering anvendt
- Destinationskontrol afventer
Eksempelkørsel · 14:32 UTC
Det ved vi
- Udbyderens svar
- Accepteret
- Skriveresultat
- Anvendt
- Tilbagelæsning fra destination
- Afventer
Et vellykket kald beviser ikke sluttilstanden.
Foreslået layout inspireret af Tajos aktivitetslog. Illustrationen tilføjer en verifikationstilstand; den påstår ikke, at tilbagelæsning fra destinationen allerede er implementeret.
Det ændrer også, hvad du bør måle. Registrer antallet af forsøg, hvis det hjælper med at forklare omkostningerne. Registrer fejl undervejs, hvis de peger på et defekt trin. Men vurder arbejdsgangen ud fra kontrollerede, afsluttede opgaver, og skriv kontrolmetoden ved siden af tallet. Et team, der rapporterer »99 % af kaldene lykkedes«, har ikke svaret på, om kunderne fik løst deres opgaver.
Introduktionen til MCP-servere viser, hvordan værktøjer lader en assistent kalde et andet system. Adgang til værktøjet er kun begyndelsen. Løftet handler om den tilstand, der er tilbage bagefter.
Hundrede gode klik kan stadig ende uden resultat. Tæl resultatet.
Ofte Stillede Spørgsmål
Hvorfor fejler en lang arbejdsgang, når dens trin som regel er korrekte?
Hvis hvert trin lykkes uafhængigt med sandsynligheden p, lykkes en kæde med n trin med sandsynligheden p opløftet i n. Med antaget 99 % succes pr. trin gennemføres hundrede trin samlet i cirka 36,6 % af tilfældene. Virkelige fejl kan hænge sammen, så beregningen er et eksempel, ikke en målt succesrate for agenter.
Garanterer færre værktøjskald større pålidelighed?
Nej. Færre kald hjælper kun, hvis den samlede handling stadig viser de nødvendige kontroller og muligheder for at rette fejl. Et enkelt uigennemsigtigt kald kan skjule en mislykket opdatering, ligesom en lang kæde kan miste overblikket.
Hvad bør et team måle i en agents arbejdsgang?
Mål, om brugerens samlede opgave er afsluttet og kontrolleret, ikke kun om modelkald lykkes. Definer den fil eller tilstand i målsystemet, der beviser, at opgaven er færdig, og registrer derefter, hvor ofte den findes efter hele forløbet.