
Auf dieser Seite
Stell dir als Beispiel eine Browser-Aufgabe mit hundert Schritten vor. Angenommen, jeder Schritt gelingt unabhängig von den anderen in 99 % der Fälle. Die Wahrscheinlichkeit, dass jeder Schritt funktioniert, ist 0.99^100, also etwa 36,6 %.
Neunundneunzig Prozent klingen hervorragend. Sechsunddreißig Prozent tun es nicht.
Die Quelldiskussion über transaktionale Browser-Aufgaben nutzt diese Rechnung für einen eng umrissenen Punkt: Kund:innen erhalten den Nutzen erst, wenn die Aufgabe abgeschlossen ist, während Kosten und Fehlerrisiko mit jedem Schritt wachsen. Das ist eine Rechnung unter einer Annahme, keine veröffentlichte Erfolgsquote eines Browser-Agenten oder eines Tajo-Syncs. In der Praxis können Fehler voneinander abhängen. Eine abgelaufene Anmeldung kann mehrere spätere Aktionen auf einmal scheitern lassen.
Die hilfreiche Frage lautet also nicht: „Wie treffsicher war der letzte Klick des Modells?“ Sie lautet: „Ist der gewünschte Zustand der Nutzer:innen eingetreten?“
Die Transaktion ist die entscheidende Einheit
Stell dir vor, ein Agent öffnet ein Versicherungsportal, sucht ein Dokument, lädt es herunter und prüft, ob es zum richtigen Konto gehört. Er kann 99 Bildschirme korrekt durchlaufen und auf Bildschirm 100 trotzdem die falsche Datei herunterladen. Ein Protokoll voller erfolgreicher Klicks macht das Ergebnis nicht richtig.
Dasselbe gilt für eine Integration. Ein Agent kann eine API finden, eine Feldzuordnung vorschlagen und einen Entwurf speichern. Keine dieser Aktionen bedeutet, dass ein Kontakt im Zielsystem jetzt den vorgesehenen Einwilligungsstatus hat. Die Arbeit ist erst abgeschlossen, wenn der freigegebene Vorgang ausgeführt und seine relevante Nachbedingung geprüft wurde.
Das ist der Unterschied zwischen Aktivität und Abschluss. Aktivität lässt sich leicht zählen. Für den Abschluss brauchst du eine Definition.
Bei einem Dateidownload könnte das eine Datei sein, deren Kontonummer zur Anfrage passt. Bei einem Kontakt-Sync könnte es ein Datensatz im Zielsystem mit der richtigen Kennung, den richtigen Feldern und dem zulässigen Status für Nachrichten sein. Die Prüfung muss genau das untersuchen, worauf es den Nutzer:innen ankam. Eine grüne Antwort des vorherigen Aufrufs belegt, dass ein Aufruf eine Antwort geliefert hat. Sie belegt möglicherweise nicht, dass sich das Zielsystem wie vorgesehen geändert hat.
Die Tajo-Anleitung zum Verbinden von Geschäftstools beginnt mit dem Workflow und der maßgeblichen Datenquelle für jedes Datenobjekt. Diese Entscheidungen geben der abschließenden Prüfung ihre Bedeutung. Wenn zwei Systeme dasselbe Feld als ihr Eigentum betrachten, kann selbst ein perfekt ausgeführter Schreibvorgang langfristig den falschen Zustand erzeugen.
Die Kosten einer weiteren Entscheidung
Unter derselben hypothetischen Annahme von 99 % ergeben zehn unabhängige Entscheidungen eine Erfolgswahrscheinlichkeit der ganzen Kette von etwa 90,4 %. Bei fünfzig sind es etwa 60,5 %, bei hundert etwa 36,6 %.
Erfolgswahrscheinlichkeit der gesamten Kette (%)
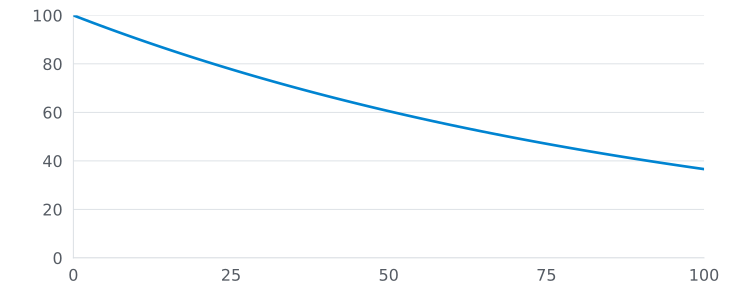
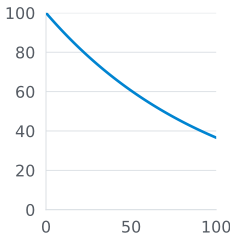
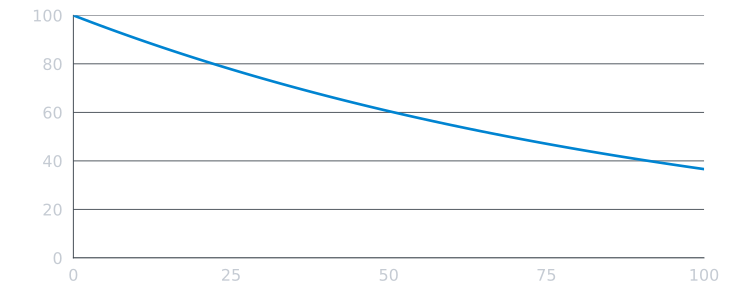
Anzahl unabhängiger Schritte
- Angenommene Erfolgsquote von 99 % pro Schritt
Berechnete Werte ansehen
| Schritte | Erfolgswahrscheinlichkeit der ganzen Kette (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
Die Kurve ist steil, weil Multiplikation keinen guten Durchschnitt belohnt. Jede zusätzliche Entscheidung muss ihren Platz rechtfertigen.
Das bedeutet nicht, dass jeder API-Aufruf zu einem riesigen Vorgang zusammengefasst werden sollte. Manche Aufrufe sind deterministisch: eine Seite mit einem bekannten Cursor abrufen, eine Kennung vergleichen oder ein Feld gemäß einer freigegebenen Zuordnung schreiben. Ein Modell muss diese Entscheidung nicht für jeden Datensatz erneut treffen. Andere Aufrufe bringen echte Mehrdeutigkeit mit sich: ein neues Anbieterfeld, eine geänderte Fehlermeldung oder eine Anfrage, deren Zuständigkeit unklar ist. Hier kann eine Bewertung nötig sein.
Die praktische Aufteilung: Die Bewertung entwirft oder repariert eine Regel. Anschließend wendet gewöhnlicher Code die stabile Regel an. Reverse ETL ist ein gutes Beispiel für wiederholte Datenbewegung: Die Pipeline sollte jede routinemäßige Zeilenoperation ausführen, keine Unterhaltung. Ein Agent kann weiterhin dabei helfen, festzulegen, was die Pipeline tun soll.
Das ist eine Grenze, kein Slogan. Wenn ein Anbieter die Bedeutung eines Feldes ändert, kann eine deterministische Regel die falsche Aktion perfekt wiederholen. Das System braucht eine Möglichkeit, geänderte Annahmen zu erkennen und den Fall erneut zur Prüfung vorzulegen.
Warum ein einziges großes Tool keine Lösung ist
Ein berechtigter Einwand lautet: „Wenn lange Ketten scheitern, packen wir die ganze Aufgabe in einen Tool-Aufruf.“ Das hilft, wenn das Tool eine klar definierte Transaktion mit überprüfbarem Ergebnis ist. Es hilft nicht, wenn es lediglich einen langen, unsicheren Prozess verbirgt.
Angenommen, syncCustomer() gibt nach dem Senden einer Aktualisierung success: true zurück. Verarbeitet das Zielsystem Aktualisierungen zeitversetzt, kann der Aufruf den endgültigen Kontaktstatus noch nicht belegen. Das Tool hat weniger sichtbare Schritte geschaffen, aber die Unsicherheit nicht verringert.
Eine bessere Schnittstelle zeigt den relevanten Status: angenommen, angewendet, geprüft oder fehlgeschlagen. Diese Begriffe müssen jeweils einem Beleg entsprechen. Für eine Vorschau mit geringen Folgen kann ein angenommener Schreibvorgang ausreichen. Bei einer Kampagnenzielgruppe oder einer Einwilligungsänderung sollte der Zustand im Zielsystem geprüft werden, bevor jemand den Vorgang als abgeschlossen bezeichnet.
In dieser vorgeschlagenen Tajo-Ansicht sind eine angenommene Anfrage und eine angewendete Aktualisierung etwas anderes als ein verifizierter Zielzustand. Die letzte Prüfung steht noch aus. Damit hat die nächste Aktion einen Zweck: nachsehen, was das Zielsystem gespeichert hat. Ein weiterer erfolgreicher Tool-Aufruf würde die ursprüngliche Frage offenlassen.
Ein abgeschlossener Schreibvorgang braucht weiterhin Belege
Wurde die Kundensynchronisierung abgeschlossen?
Schreibvorgang angewendet. Prüfung ausstehend.
Der Zielzustand wurde noch nicht geprüft.
Sync-Aktivität
- Anfrage angenommen
- Aktualisierung angewendet
- Zielprüfung ausstehend
Beispielhafter Durchlauf · 14:32 UTC
Was wir wissen
- Antwort des Anbieters
- Angenommen
- Ergebnis des Schreibvorgangs
- Angewendet
- Rücklesung aus dem Zielsystem
- Ausstehend
Ein erfolgreicher Aufruf belegt den Endzustand nicht.
Vorgeschlagenes Layout auf Grundlage von Tajos Aktivitätsverlauf. Die Illustration ergänzt einen Prüfstatus und behauptet nicht, dass die Rücklesung aus dem Zielsystem bereits implementiert ist.
Das ändert auch, was gemessen wird. Erfasse die Zahl der Versuche, wenn sie bei der Kostenanalyse hilft. Erfasse Zwischenfehler, wenn sie auf einen defekten Schritt hinweisen. Beurteile den Workflow aber anhand verifizierter abgeschlossener Transaktionen und nenne neben der Zahl auch die Prüfmethode. Ein Team, das meldet, „99 % der Aufrufe waren erfolgreich“, beantwortet nicht die Frage, ob die gewünschte Arbeit für Kund:innen erledigt wurde.
Der Erklärartikel zu MCP-Servern zeigt, wie Tools einem Assistenten den Aufruf eines anderen Systems ermöglichen. Der Tool-Zugriff ist nur der erste Schritt. Entscheidend ist der Zustand, den das System hinterlässt.
Hundert gelungene Klicks können trotzdem nichts bewirken. Zähle das Ergebnis.
Häufig gestellte Fragen
Warum scheitert ein langer Workflow, obwohl seine einzelnen Schritte meist funktionieren?
Wenn jeder Schritt unabhängig mit Wahrscheinlichkeit p gelingt, beträgt die Erfolgswahrscheinlichkeit einer Kette aus n Schritten p hoch n. Bei angenommenen 99 % pro Schritt wird eine Kette aus hundert Schritten nur in etwa 36,6 % der Fälle vollständig abgeschlossen. Tatsächliche Fehler können zusammenhängen, daher ist die Rechnung ein Beispiel und keine gemessene Erfolgsquote eines Agenten.
Garantiert eine geringere Zahl von Tool-Aufrufen mehr Zuverlässigkeit?
Nein. Weniger Aufrufe helfen nur, wenn der zusammengefasste Vorgang weiterhin die richtigen Prüfungen und Wiederherstellungspunkte bietet. Ein einzelner undurchsichtiger Aufruf kann einen fehlgeschlagenen Schreibvorgang genauso gut verbergen wie eine lange Kette den Überblick verlieren kann.
Was sollte ein Team bei einem Agenten-Workflow messen?
Miss den verifizierten Abschluss der Transaktion, die Nutzer:innen angefordert haben, und nicht nur erfolgreiche Modellaufrufe. Definiere das Artefakt oder den Zielzustand, der den Abschluss belegt, und erfasse anschließend, wie oft er nach dem gesamten Workflow vorliegt.